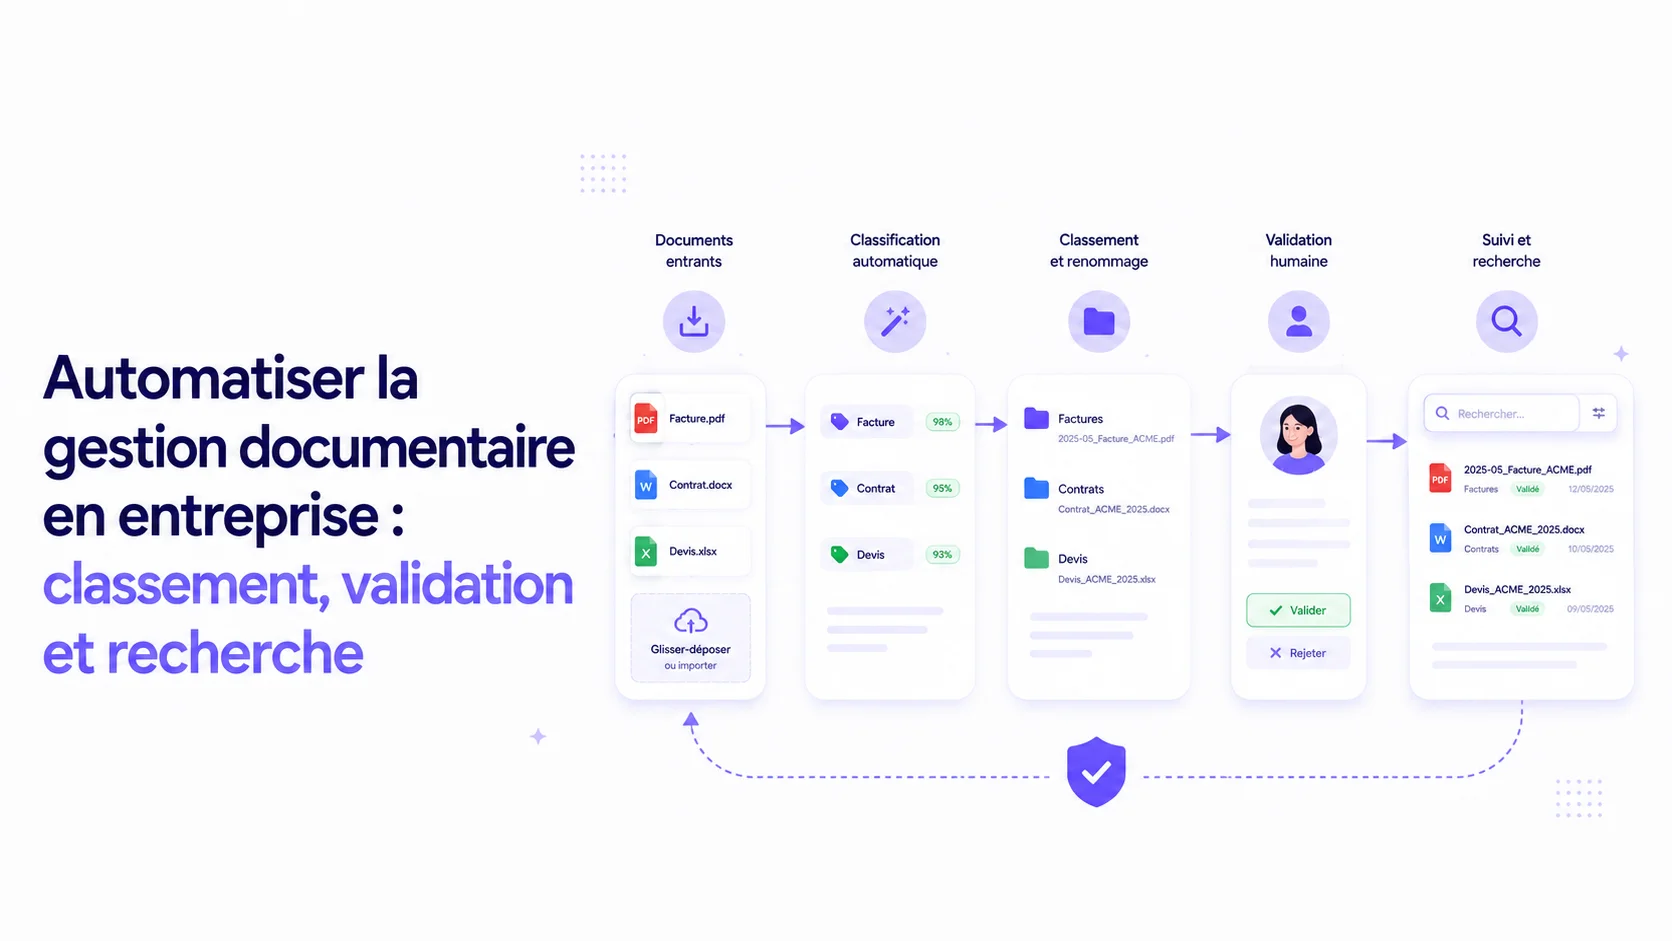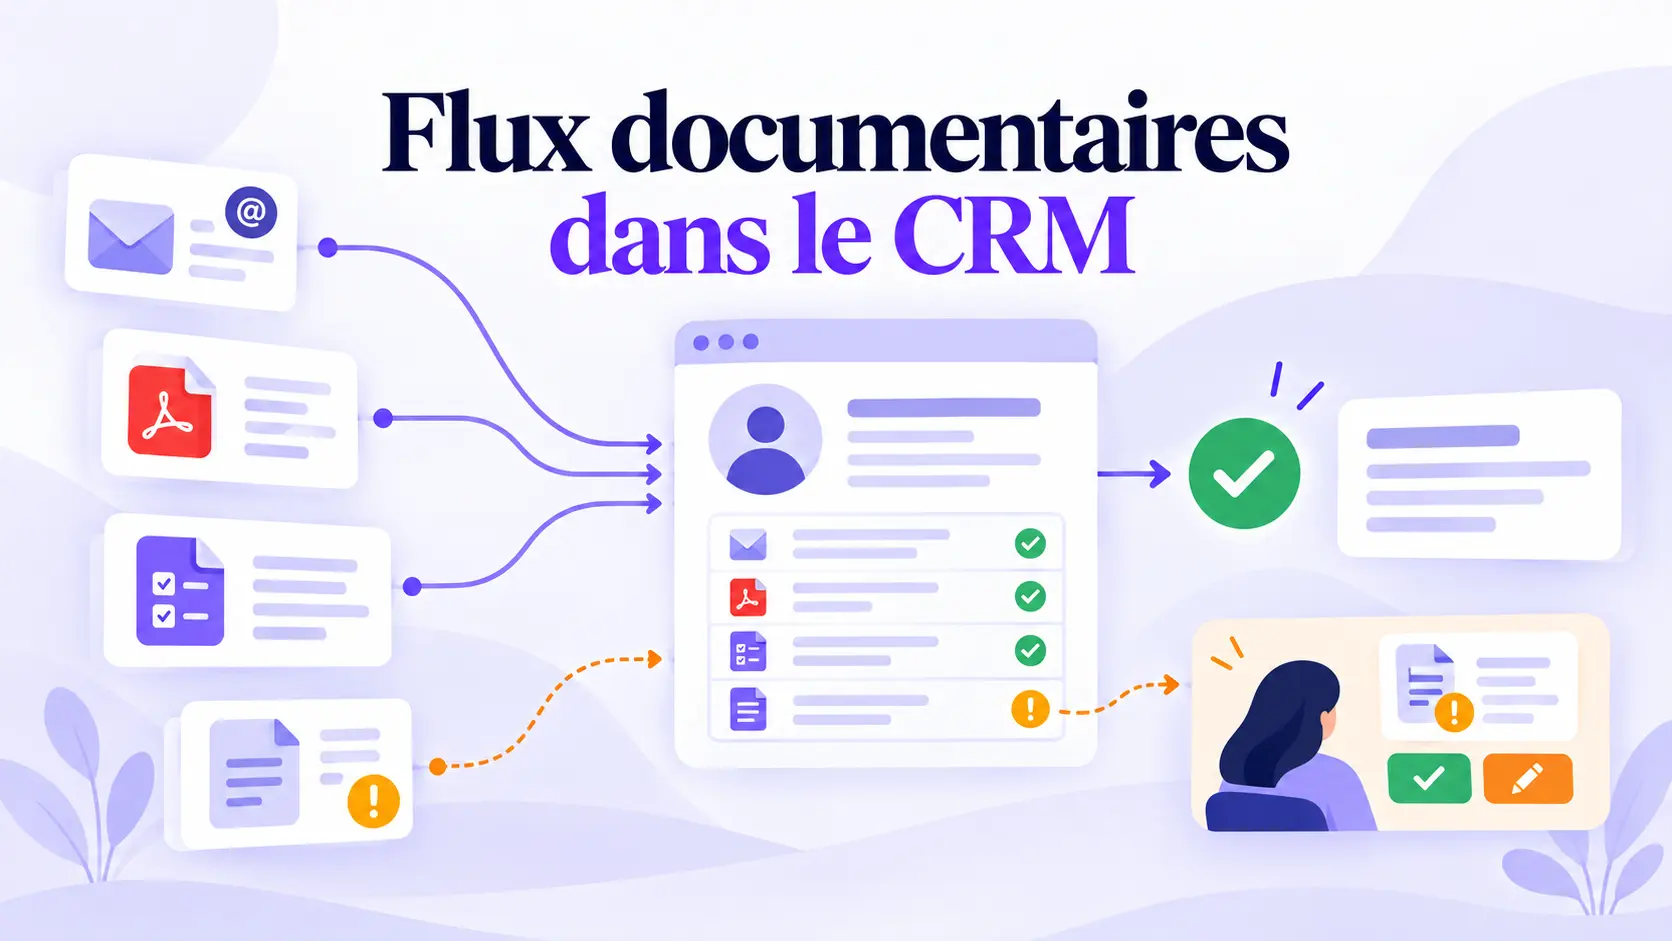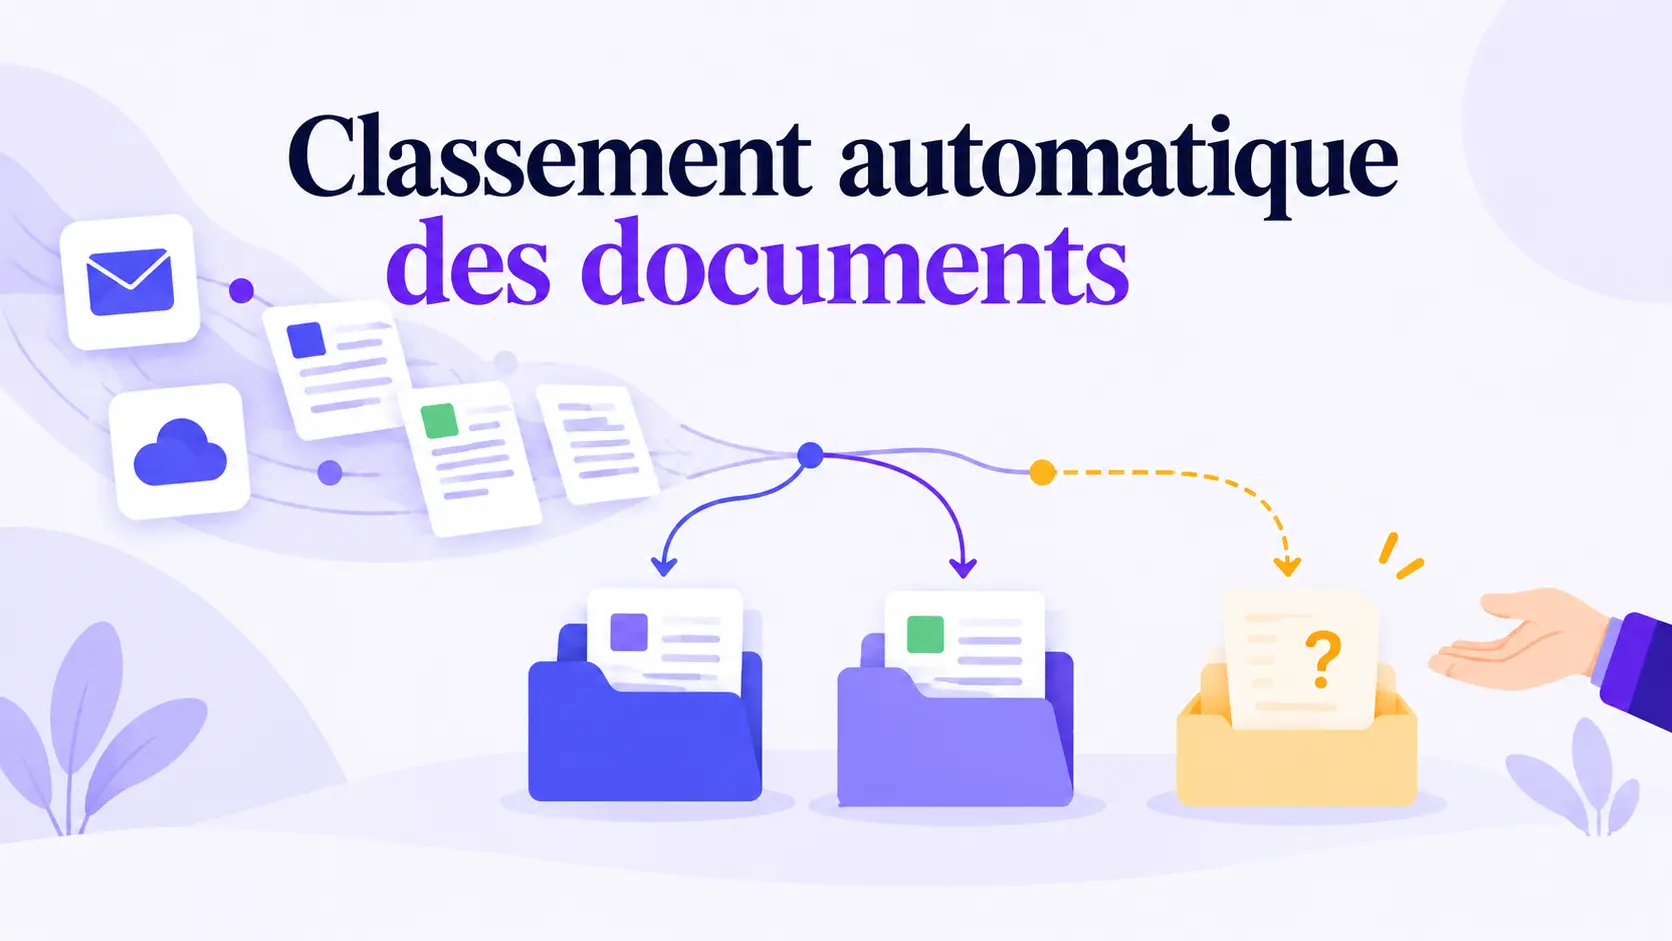
Le classement automatique des documents consiste à reconnaître un fichier entrant, lui attribuer une catégorie et un identifiant, puis l'orienter vers le bon emplacement avec les métadonnées qui permettront de le retrouver. Il faut aussi savoir arrêter le flux si la catégorie est incertaine : un document mal rangé peut devenir invisible alors même que l'automatisation indique « terminé ».
Ce guide répond à une question précise : comment décider où ranger chaque fichier et vérifier cette décision ? La gestion documentaire en entreprise présente le parcours complet, tandis que le workflow documentaire automatisé relie réception, contrôle, validation et archivage. Ici, nous détaillons la seule étape de classification et de rangement, que votre équipe utilise Drive, SharePoint ou une GED.
Que signifie exactement « classer automatiquement » ?
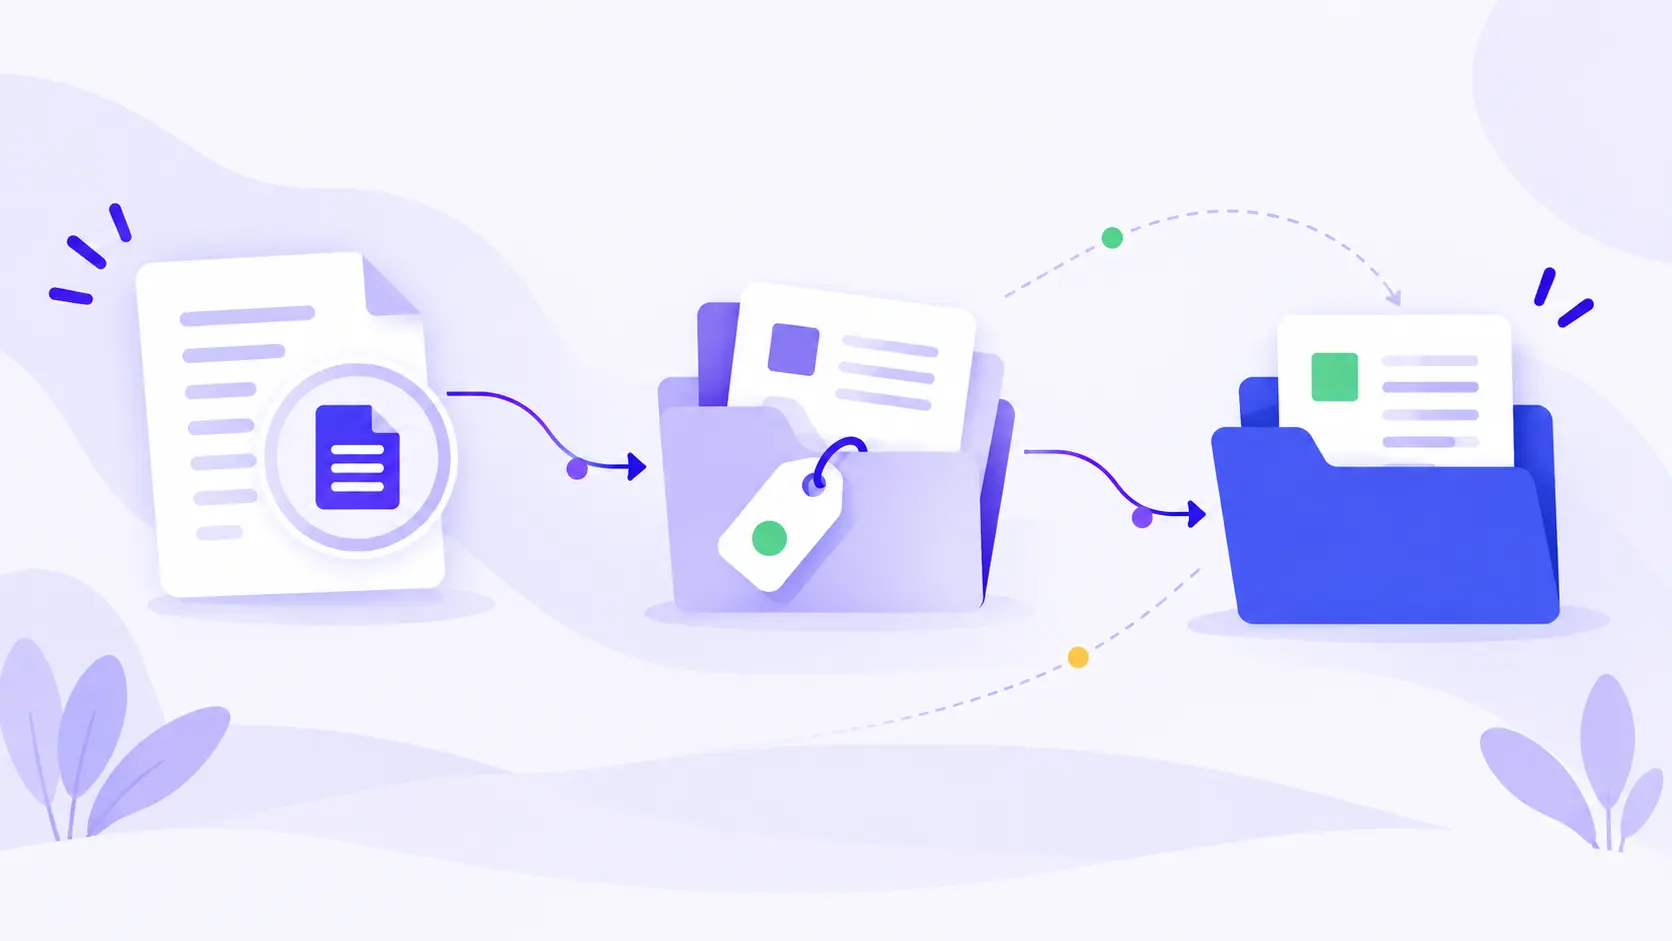
Le classement réunit trois décisions distinctes. Identifier le type de pièce : contrat, devis, facture ou justificatif. Rattacher la pièce au bon dossier : client, projet ou opération. Définir son emplacement et ses métadonnées : statut, propriétaire, date, lien d'origine. Déplacer le fichier sans ces trois décisions revient souvent à déplacer le désordre.
Un exemple hypothétique : une PME reçoit par e-mail un devis signé, un bon de commande et une facture pour un même client. Les trois pièces appartiennent au dossier client, mais pas à la même catégorie ni au même statut. Une règle fondée sur le seul nom du client risque de les ranger ensemble sans rendre leurs rôles visibles. Une règle fondée sur la seule extension « PDF » n'aide pas davantage.
Le rangement physique et la recherche ne sont pas non plus identiques. Dans SharePoint, les colonnes et types de contenu servent à organiser, filtrer et retrouver les éléments d'une bibliothèque ; dans Google Drive, la recherche propose notamment des filtres par type de fichier, personne et date. Ces possibilités varient selon l'outil et la configuration. Microsoft décrit le rôle des métadonnées dans SharePoint et Google documente la recherche dans Drive.
Définir une taxonomie courte avant les règles
Commencez avec les documents réellement reçus, pas avec l'arborescence rêvée. Relevez un petit échantillon représentatif : fichiers correctement rangés, pièces sans nom exploitable, documents mixtes, doublons et mauvais dépôts. Pour chaque type, indiquez sa source, le dossier métier qui fait foi, le responsable et l'action suivante.
Une taxonomie utile peut tenir en quelques catégories stables : « devis », « commande », « contrat », « facture », « justificatif » et « autre à vérifier ». Si deux équipes donnent deux sens différents à « justificatif », clarifiez la définition avant d'automatiser. Si une catégorie n'entraîne aucune règle de rangement ou de traitement différente, elle est peut-être trop détaillée.
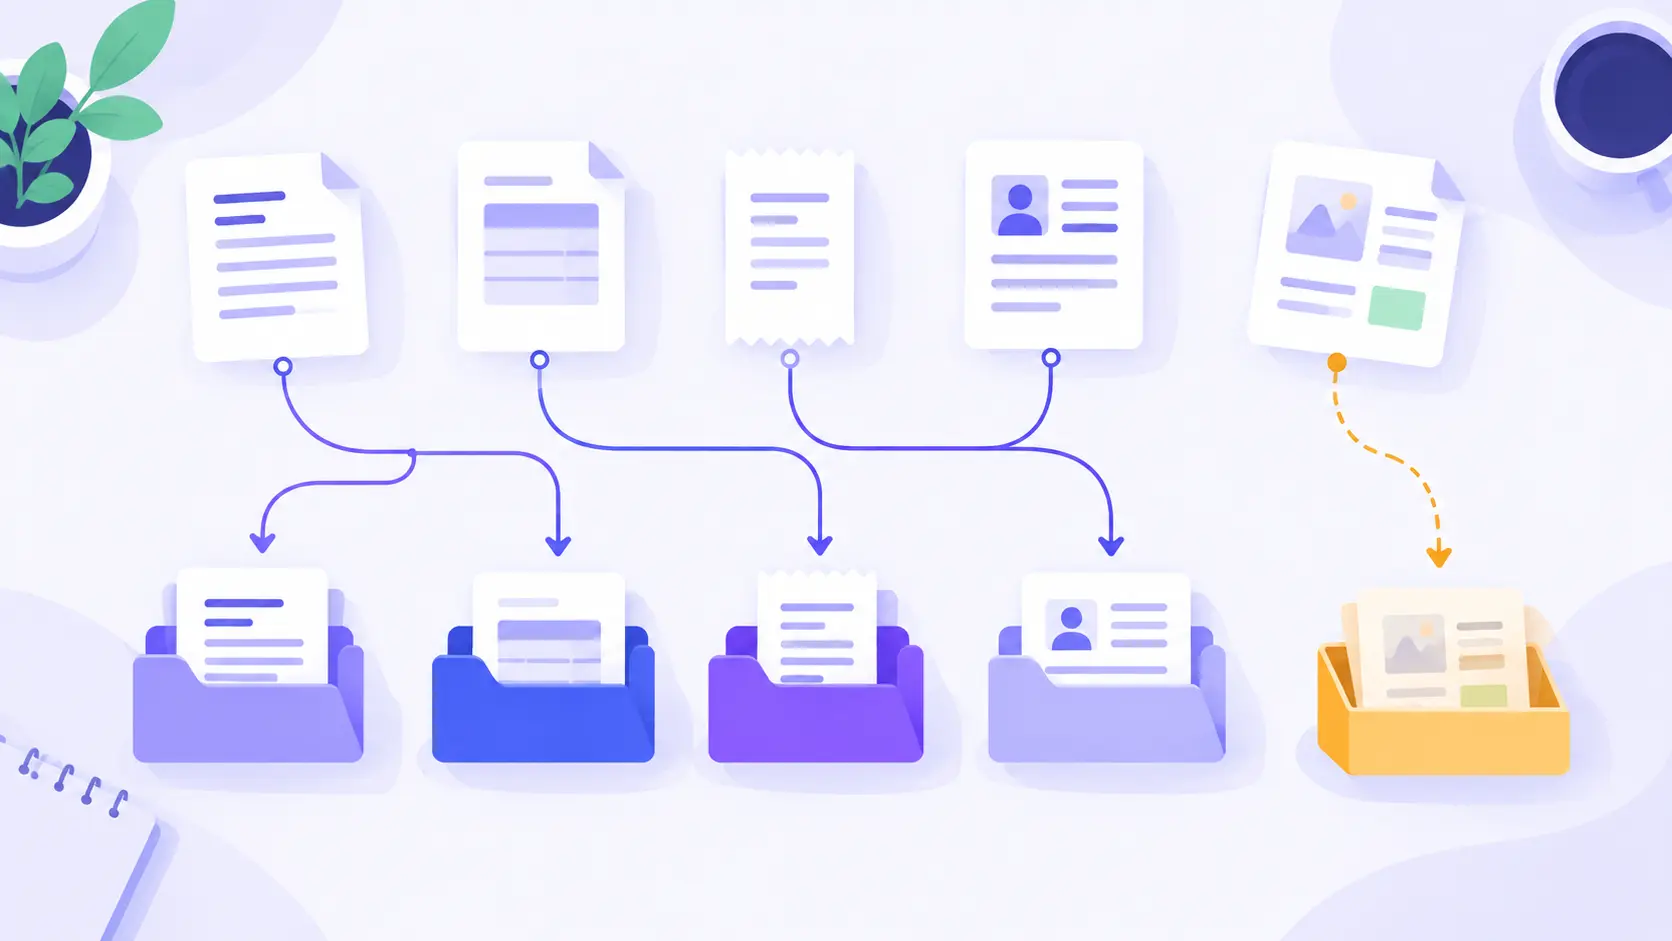
Définissez aussi une clé de rattachement stable, par exemple l'identifiant du client ou du projet dans l'outil métier. Un nom commercial peut changer ; deux clients peuvent avoir des noms proches. L'identifiant protège la continuité du dossier. Le nom du fichier peut ensuite suivre une convention lisible, comme 2026-09-client-contrat-reference, sans porter à lui seul toutes les informations utiles.
Choisir les indices de classement dans le bon ordre
Une règle fiable combine plusieurs indices. Le canal d'arrivée est un premier signal : un portail fournisseur, une boîte « factures » ou un dépôt client. Il ne suffit pourtant pas, car une même boîte reçoit parfois devis, relances et documents mal adressés. Ajoutez les informations déjà connues du dossier : identifiant de la demande, expéditeur attendu, référence de commande ou type de pièce demandé dans un formulaire.
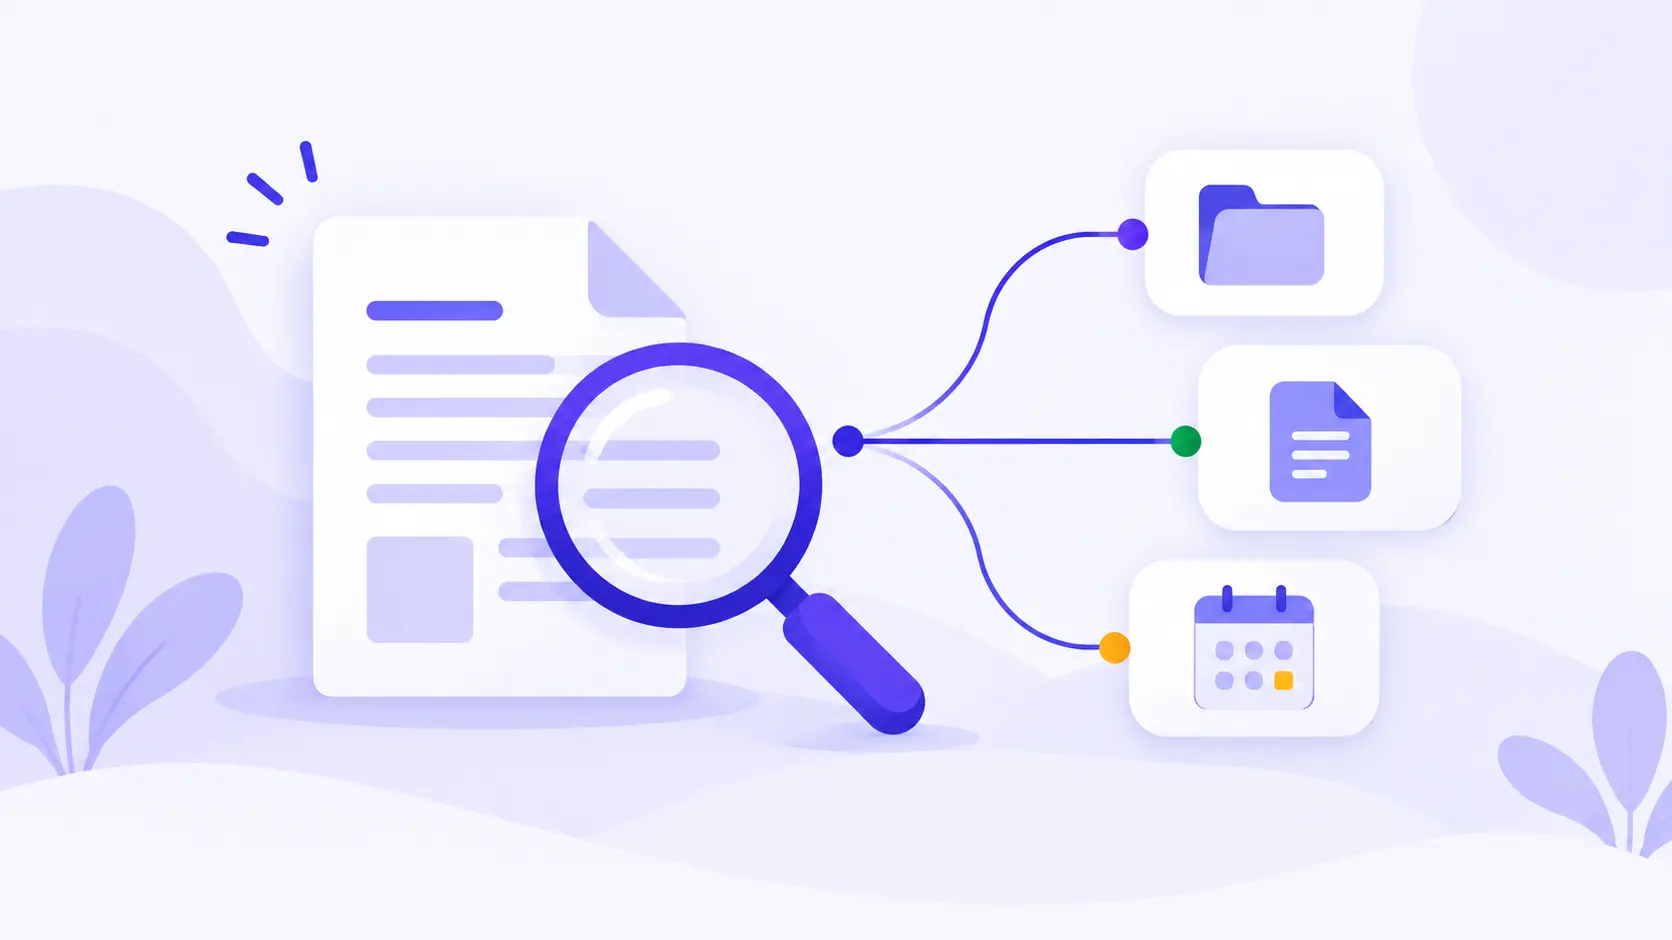
Le contenu du document peut départager les cas restants. Un champ extrait du PDF, un titre ou une structure récurrente peuvent aider à proposer une catégorie. S'il s'agit d'un scan, une étape OCR peut être nécessaire ; le guide sur l'extraction de données PDF explique la différence entre lecture de texte et extraction de champs. Une prédiction de catégorie n'est pas une preuve que le contenu est conforme. Le contrôle métier vient après le classement.
Prenons notre exemple fictif. Un PDF arrive depuis un portail lié au dossier CL-042. Le formulaire indique « bon de commande » et une référence de commande est présente. Le système peut proposer cette catégorie puis vérifier que le dossier CL-042 existe. Si la référence manque ou si le texte ressemble à une facture, il doit demander une vérification plutôt qu'inventer un emplacement plausible.
Dessiner le chemin nominal et la file des cas ambigus
Un premier workflow peut se lire sans connaître son outil d'automatisation :
- Enregistrer le fichier entrant avec un identifiant, sa source et son lien d'origine.
- Déterminer le dossier métier grâce à un identifiant connu ; sinon demander le rattachement.
- Proposer la catégorie avec des règles explicites et, si nécessaire, une lecture du contenu.
- Vérifier que le chemin cible existe et que le dépôt n'a pas déjà été traité.
- Ranger le fichier, écrire ses métadonnées et enregistrer le résultat.
- Envoyer les dossiers incertains dans une file où une personne peut corriger la catégorie ou le rattachement.
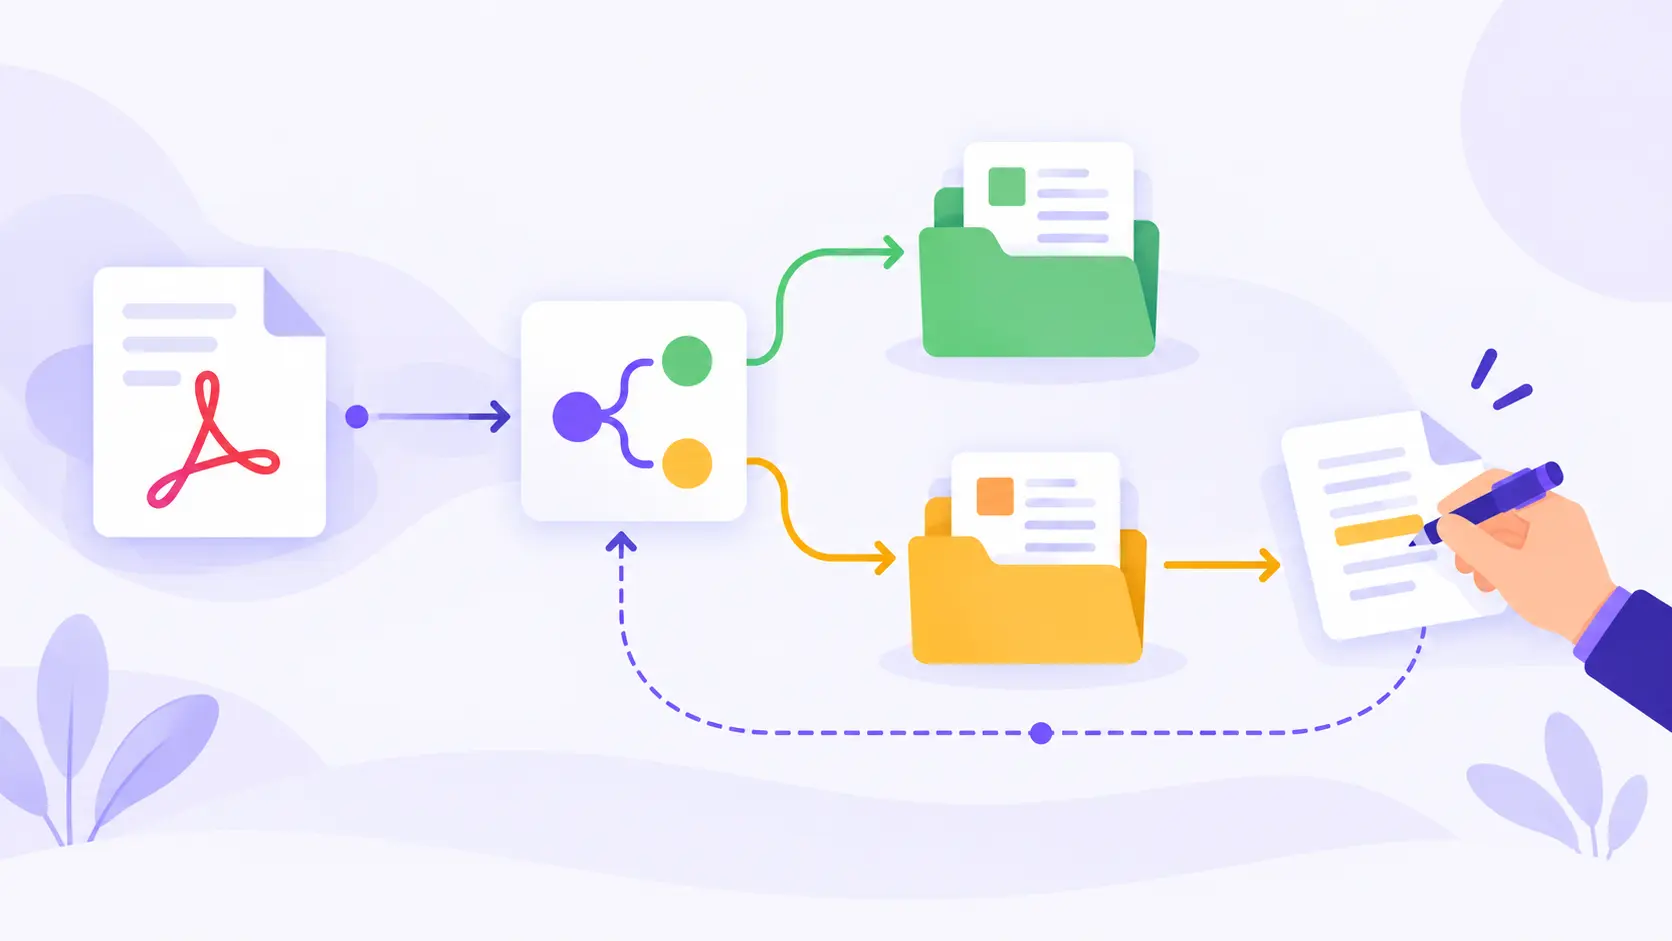
Cette file doit expliquer le motif : « référence client absente », « deux catégories possibles » ou « emplacement inaccessible ». Elle doit présenter le fichier et les indices détectés. Une personne choisit le bon dossier, corrige la fiche, puis relance le même traitement ; créer un nouveau fichier à chaque correction rend les doublons difficiles à repérer.
Deux documents identiques peuvent arriver par des canaux différents. Conservez une clé d'événement ou une empreinte adaptée au processus et vérifiez aussi les références métier. Une empreinte identique révèle deux fichiers aux mêmes octets, mais deux scans du même original peuvent avoir des empreintes différentes. La décision de fusionner ou de bloquer dépend alors du type de pièce et du risque de perdre une version utile.
Comment rendre les documents retrouvables ?
Le dossier donne un emplacement ; les métadonnées donnent des points d'entrée. Une fiche minimale peut contenir : identifiant du dossier métier, type, date de réception, origine, responsable, statut de classement et lien vers le fichier. Ajoutez la référence de commande ou la période uniquement si l'équipe s'en sert pour chercher ou contrôler. Trop de champs obligatoires encouragent la saisie de valeurs fictives.
Testez la recherche avec une personne qui n'a pas classé le fichier. Peut-elle retrouver « le bon de commande du projet X reçu la semaine dernière » sans connaître son nom exact ? Peut-elle distinguer le document actif d'une ancienne version ? La gestion automatisée des versions traite ce dernier point. Ne multipliez pas les copies du même document pour satisfaire plusieurs arborescences : un lien ou des métadonnées peuvent suffire selon les possibilités de votre outil.
Droits d'accès et conservation : des règles du dossier, pas du classement
Un classement réussi ne doit pas ouvrir automatiquement un dossier sensible à toute l'entreprise. Associez les droits au besoin réel des personnes concernées, puis vérifiez les permissions héritées du dossier de destination. La CNIL recommande de limiter les accès et de réexaminer les habilitations. Un changement de catégorie peut donc nécessiter un autre emplacement ou une revue des accès.
De même, « ranger » et « archiver » ne sont pas synonymes. La durée de conservation dépend de la finalité des données et du contexte applicable ; le workflow de classement ne doit pas inventer un délai unique pour contrats, candidatures et factures. La CNIL expose les principes de durée de conservation. Faites valider ces règles par la personne responsable du traitement et de la conformité avant de programmer une suppression automatique.
Mesurer la qualité sans confondre vitesse et justesse
Sur un lot de documents représentatif, comparez les propositions du système à un classement vérifié par l'équipe. Suivez séparément les catégories correctes, les mauvais dossiers métier, les pièces non classées et les erreurs qui ont échappé à la file de vérification. Notez aussi combien de temps il faut pour retrouver une pièce après son dépôt ; un déplacement rapide sans retrouvabilité n'est pas un succès.
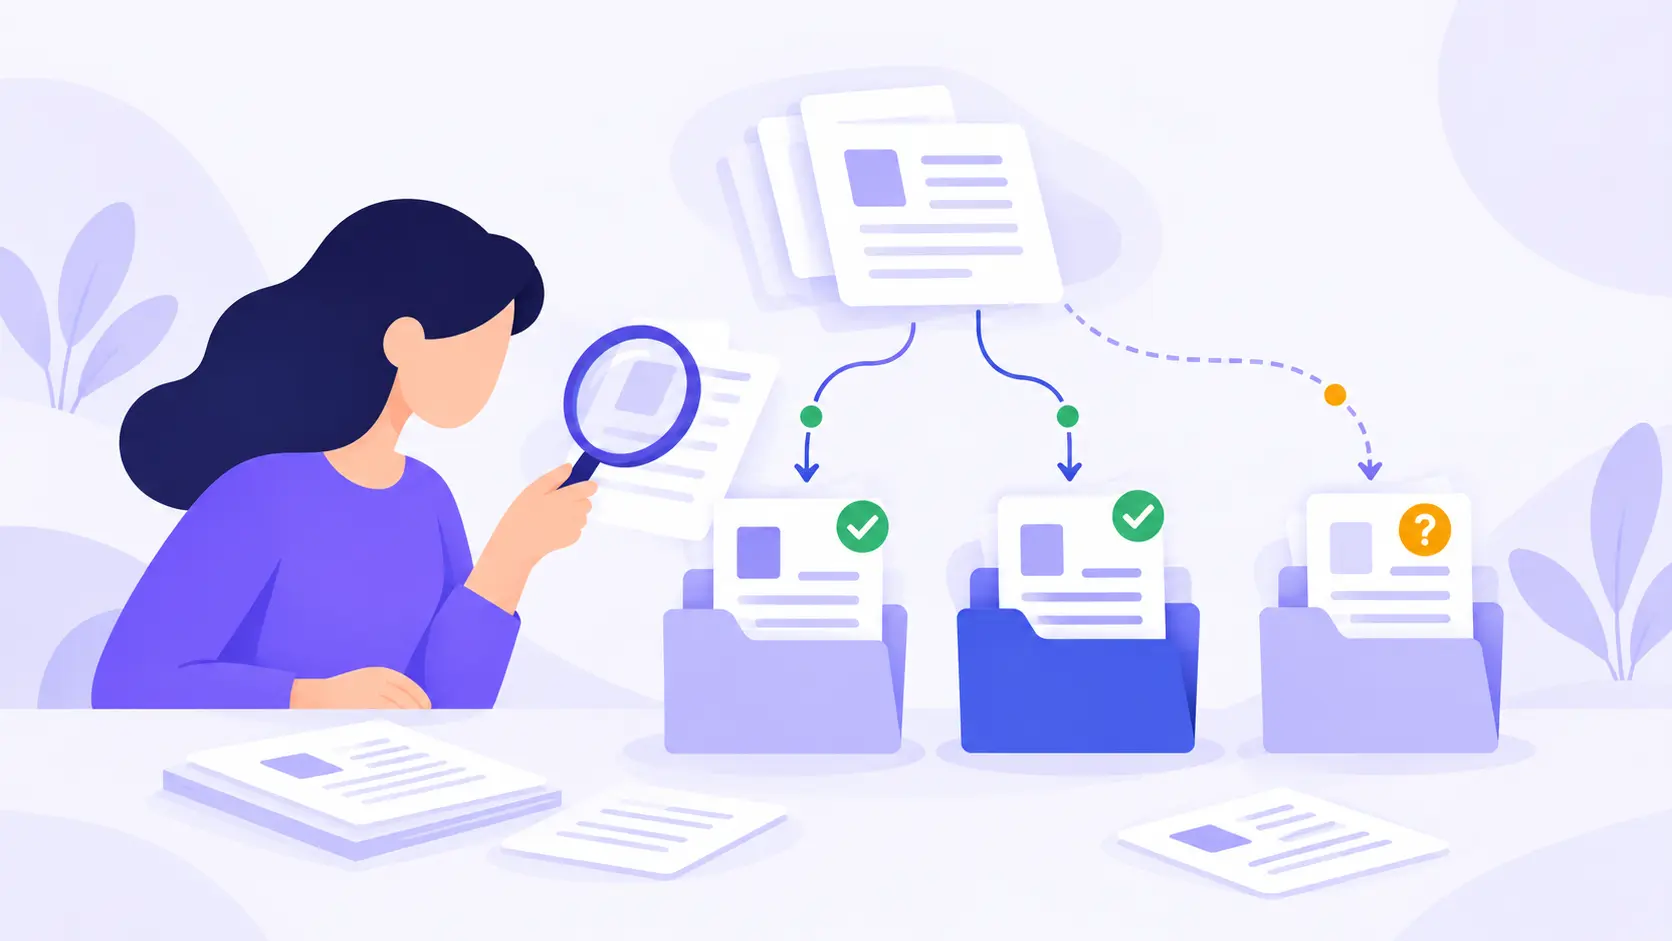
Commencez par un type de document et un canal d'entrée. Corrigez la règle qui provoque le plus de mauvais rattachements, puis ajoutez d'autres catégories. La solution d'automatisation documentaire Automalis permet de cadrer ce premier flux dans les outils déjà utilisés, avec une file d'exceptions et un suivi lisible.
En résumé
Pour classer automatiquement des documents, définissez peu de catégories, rattachez chaque fichier à un dossier métier stable et séparez les cas sûrs des cas ambigus. Vérifiez ensuite que les documents sont réellement retrouvables, que leurs accès restent adaptés et que les corrections humaines reprennent le même dossier. Le bon premier pilote est une source de documents fréquente, avec des erreurs que l'équipe sait déjà reconnaître.